从任务出发
场景假设:制作短篇故事或内容样片的个人创作者。原项目已有云端配音作品与确认记录;本版保留它们,并新增可复现的本机局部返工。
不可变原文分段AI角色标注人工确认逐段配音 / 返工归一化合成 / 时间轴
| 优先级 | 需求 | 依据 |
|---|---|---|
| Must | 原文完整性与角色确认 | 防止漏字、改写和错误说话人 |
| Must | 局部失效与重新生成 | 只重做变化片段,保留其他已选音频 |
| Must | 真实试听、合成和版本追踪 | 音频文件、脚本与时间轴应对应同一版本 |
| Should | 费用与引擎标识 | 已有云端音频与Windows系统语音不可混称同音质 |
| Could | 云端多音色与主观听评 | 需要额外配置和真实听评样本;本次优先复现交付 |
比较过的方案与取舍
| 选项 | 主要问题 | 本版选择 |
|---|---|---|
| 模型直接重新输出原文 | 首轮3个样例仅1个保持全文一致 | 改为程序持有文本段,模型只输出id与speaker |
| 修改后沿用旧声音 | 台词与音频可能失配 | 文本、角色或语速变化使对应音频引用失效 |
| 每次重生成整篇 | 代价大且已通过片段发生漂移 | 分段存储与局部重新生成,再归一格式合成 |
用户完成任务的过程
- 输入原文,程序保持文字并分段
- 模型只标注角色,混合或不明确角色待确认
- 人工修改台词或角色后使旧音频失效
- 逐段配音与试听,只返工所选片段
- 统一音频格式,拼接完整作品并导出时间轴
可操作界面与验收条件
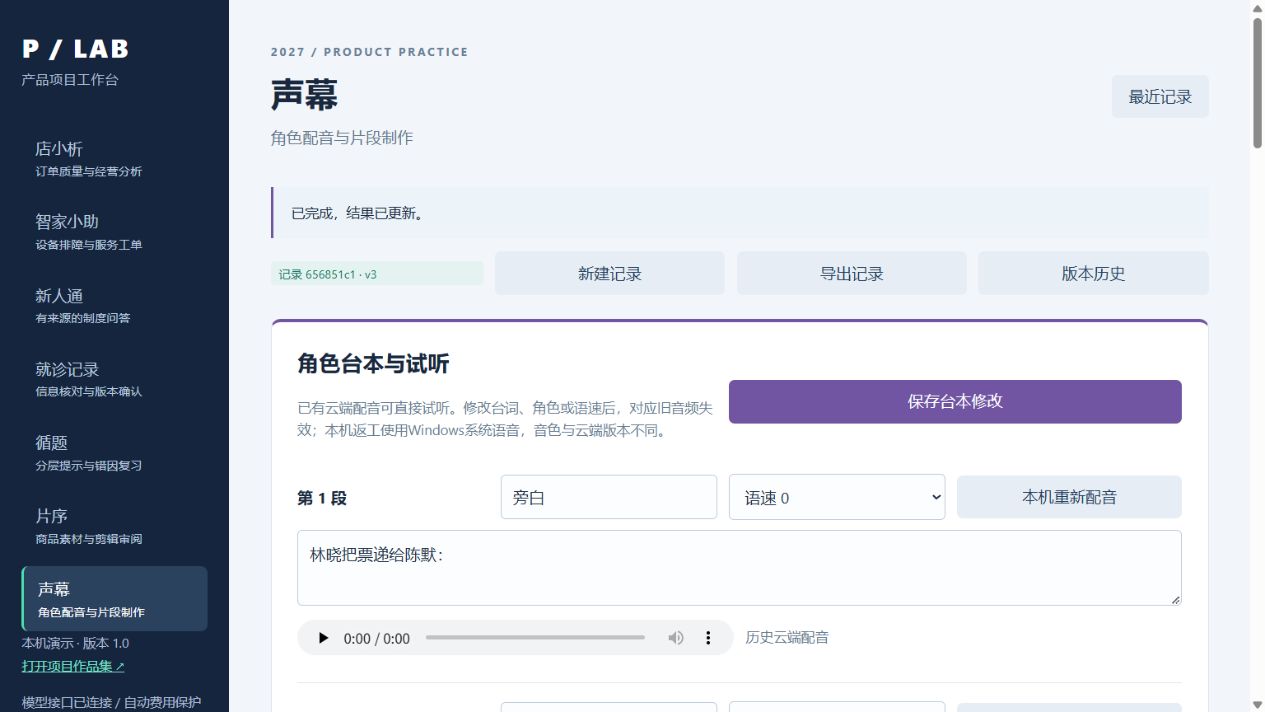
实际界面截图。公开站点用于展示案例,程序在本机运行。
| 功能 | 交互与规则 | 验收 |
|---|---|---|
| A01 原文与角色 | 程序分段后拼接应逐字等于原文;角色id完整,不明标注待确认 | 待确认角色不能批准配音;原文保持回归3例及新增3例 |
| A02 局部返工 | 修改text/speaker/rate使相应audio为空,未改片段保留 | 经确认后可本机生成单段,明确Windows SAPI引擎 |
| A03 合成 | 所有片段具备可用音频才可导出;统一单声道24kHz PCM | 实际11段合成WAV,时间轴包含id、起止时间、角色与台词 |
完成证据与一次关键迭代
本项目功能检查:5/5
本轮真实API评测发现模型拆分时删去引号或角色前缀。没有通过放宽检查来掩盖问题,而是把文字所有权移回程序,模型只判断角色。3条原回归和3条新样例均保留原文;混合角色仍要求人工确认。
| 类别 | 指标 | 验证状态 |
|---|---|---|
| 业务目标 | 达到可接受听感的制作时长与返工成本 | 需独立创作者听评和任务计时,尚未验证 |
| 文本指标 | 原文完整率、未知角色处理 | 首轮模型重写式拆分1/3;改进后6/6保留原文,样本规模明确 |
| 媒体指标 | 可解码、采样格式、片段引用和合成时长 | 已实际导出11段合成音频并验证局部生成 |
| 成本指标 | 模型token、语音引擎、重做范围 | 新模型调用有台账;Windows本机语音不产生云端TTS调用费 |
范围限制与面试追问
原文保持不等于角色完全正确或声音自然。本机SAPI与历史云端音色不同,无云端情感音色一致性保证;没有独立听众打分或专业配音质量评估。
为什么改Prompt还不够?
模型仍可能在转写中删字。程序保留原文让这类问题从生成约束变成确定性属性,减少靠提示词承诺的风险。
角色正确性怎么评估?
需按台词标注已知角色、未知角色和混合片段,分别计算准确与误判。当前只验证部分样例与待确认机制,不声称全量正确。
局部生成省了多少成本?
可以确定只调用所选片段,不必重做其他片段;本次没有与云端全篇生成做完整成本对照,因此不写节省百分比。
怎样说明AI辅助贡献?
原项目选声、确认与素材操作由本人在指导下完成;此次代码、评测及交付由AI辅助实施。面试重点讲能理解和验证的需求、规则、取舍与复盘,不冒充独立手写全部代码。
来源与证据
公开产品资料用于理解能力范围,没有假称开展竞品付费实测。
- Descript · https://www.descript.com/ · 文本驱动音视频编辑作为直接参照;本项目聚焦分段状态与返工证据。
- ElevenLabs Studio · https://elevenlabs.io/studio · 创作者音视频制作产品作为参照;不据其宣传效果推断本项目声音质量。