从任务出发
场景假设:新人查询入职、请假、差旅、转正与账号流程;HR负责维护知识。使用虚构星河科技制度,不包含真实企业内部文件。
问题 / 人员范围上下文补全BM25章节检索原文+引用式生成反馈 / 转人工
| 优先级 | 需求 | 依据 |
|---|---|---|
| Must | 来源章节与人员范围 | 避免正式员工制度套用到实习生 |
| Must | 个人状态与制度解释隔离 | 未连接审批系统不能猜测个人是否通过 |
| Must | 可复现检索评测 | 看目标章节排名而不只看回答是否流畅 |
| Should | 文档版本、哈希与反馈 | 定位知识变化与具体失效来源 |
| Could | 权限系统及增量同步 | 真实企业接入时需要;本版不伪造账号权限 |
比较过的方案与取舍
| 选项 | 主要问题 | 本版选择 |
|---|---|---|
| 纯Prompt回答 | 无法追踪制度来源,知识更新不受控 | 使用检索增强;答案与原文章节一起展示 |
| 语义向量库作为默认 | 小规模中文制度可先建立透明、可调试基线 | 本版采用字符二元词BM25和标题加权;不把它称为神经Embedding |
| 关键词出现即回答 | 个人状态、越范围和无依据问题也可能有词命中 | 加入范围判断、个人状态转人工与引用格式校验 |
用户完成任务的过程
- 明确人员类型和事项
- 短追问补充上一轮语境
- 检索章节并展示相关度
- 核对制度范围与原文
- 生成带引用说明或转人工,保存反馈
可操作界面与验收条件
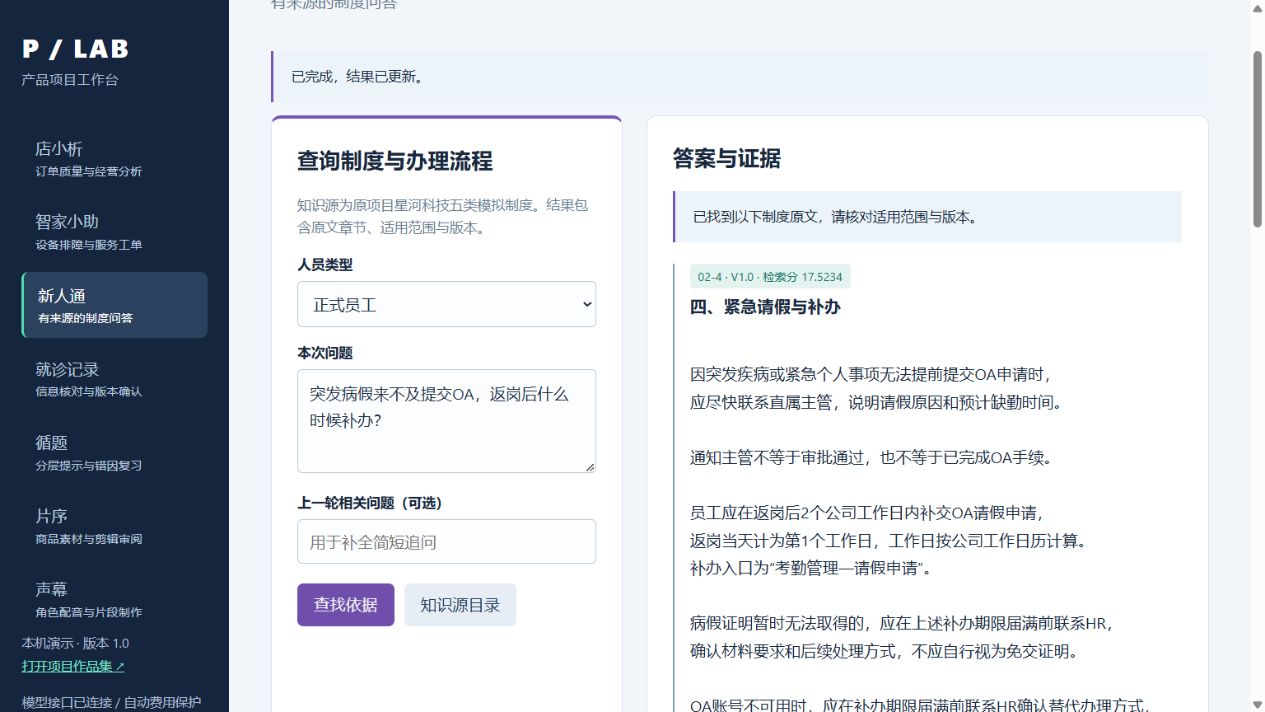
实际界面截图。公开站点用于展示案例,程序在本机运行。
| 功能 | 交互与规则 | 验收 |
|---|---|---|
| K01 知识载入 | 按原文章节切块,保留文件名、文档版本、适用范围与内容哈希 | 知识源更新后重新读取;DSL与知识源分开备份 |
| K02 检索 | 记录query、候选id及分数;比较简单词重合与BM25+标题加权 | 21个开发问题固定目标章节,报告Top1、Top4及MRR |
| K03 回答 | 正文引用[id]必须来自本轮检索;无引用或非法引用阻止展示模型草稿 | 引用格式通过不等于每句语义有据;同时保留原文供核对 |
完成证据与一次关键迭代
本项目功能检查:25/25
简单词重合排序对常用制度术语区分不足。本版加入BM25稀有词权重与标题加权,固定开发集Top1由17/21到19/21,Top4未提升。这说明排序改善,不能说明所有问答准确率已达100%。
| 类别 | 指标 | 验证状态 |
|---|---|---|
| 业务目标 | 正确找到适用流程的任务完成时间 | 目标员工试用尚未执行 |
| 检索指标 | Top1 / Top4 / MRR | 21条开发集,基线Top1 17/21,改进19/21;Top4均21/21 |
| 生成指标 | 引用覆盖、无依据陈述、拒答适当性 | 6条模型回答检查引用格式;语义仍需逐条评审 |
| 服务指标 | 延时、反馈、知识更新可追溯 | 记录真实API耗时和本地事件;未做企业并发SLA |
范围限制与面试追问
开发问题依据现有章节编制,存在样本选择偏差;不是独立测试集。没有用户级权限、企业单点登录、审批执行或完整提示注入防御。
RAG是否保证不幻觉?
不保证。检索可能缺漏,模型可能误读,引用也可能只对格式。需要分别评估检索、答案支持和范围拒答。
为什么没直接用向量数据库?
已在独立技术实验中实测MiniLM与Chroma。同一21题上,向量与改进词法Top1均19/21、Top4均21/21;未发现这组小样本上的净收益,因此应用暂保留更易定位问题的词法方案。没有证明语义检索在其他问题上无价值。
Top1提高证明什么?
在这21个开发问题上,目标章节更常排第一。并未提高Top4覆盖,也不证明总体问答正确率提升同样幅度。
制度版本与数据权限有什么区别?
版本说明采用哪份制度,权限决定哪些人能看哪些内容。展示版本不能代替鉴权。
来源与证据
公开产品资料用于理解能力范围,没有假称开展竞品付费实测。
- Microsoft Copilot Studio知识源 · https://learn.microsoft.com/en-us/microsoft-copilot-studio/knowledge-copilot-studio · 官方区分知识来源、用户鉴权和引用。本项目实现章节来源与版本展示,没有复刻企业权限能力。